

※この記事はGitGuardianのブログを日本語に翻訳したものです。
最近の研究により、GitHub CopilotをはじめとするAIコードアシスタントが、学習データに含まれる実在のハードコードされたシークレットを漏えいさせる可能性があることが明らかになりました。これは、GitHub Copilotにとって重大なセキュリティリスクとなります。攻撃者はプロンプトエンジニアリングを駆使することで、運用可能な認証情報を抽出できる可能性があります。このリスクを軽減するには、強力なシークレットスキャン、認証情報の一元管理、そしてAIが生成したすべてのコードに対する厳格なコードレビュープロセスを徹底しなければなりません。AIによる認証情報の漏えいを防ぐには、予防的な対策が不可欠です。
Yes, GitHub’s Copilot can Leak (Real) Secrets
https://blog.gitguardian.com/yes-github-copilot-can-leak-secrets/
この記事のポイント
- GitHub Copilotから実在するシークレットが抽出される可能性
研究では、プロンプトを工夫することでGitHub Copilotからハードコードされた認証情報を抽出できることが示され、少なくとも200件はGitHub上で実在するシークレットとして特定されました。 - 過去に漏えいした認証情報がAIを介して再び露出するリスク
GitHub上に一度公開されたシークレットは、Gitの履歴から削除されていても、学習データを通じてモデルに記憶され、AIコードアシスタントから再び出力される可能性があります。 - AIコード補完を前提としたシークレット管理とコードレビューが重要
リスクを抑えるには、認証情報の一元管理やシークレットスキャン、人によるコードレビューなどを開発プロセスに組み込み、AIが生成したコードも継続的に確認することが重要です。
GitHub Copilotに潜むシークレット漏えいのセキュリティリスク
研究者らは、ハードコードされた有効なシークレットをCopilotおよびCodeWhispererから抽出することに成功しました。これにより、シークレットの拡散に伴う新たなセキュリティリスクが明らかになりました。
ChatGPTやOpenAIのGPTのような先進的言語モデルには、倫理やプライバシー上の懸念があり、特に最近はそれに対する注目がますます高まっています。こうした懸念は、このようなモデルの利用に伴う潜在的なリスクについて、重要な問いを投げかけています。しかし、注意しなければならないのは、このような汎用の大規模言語モデルだけではありません。AIコーディングアシスタントのような特化型ツールにも、そうしたツールならではの懸念が存在します。
GitHubのブログ記事によると、GitHubのコード生成ツール「Copilot」は、リリースから1年が経ったところで、100万人の開発者が利用し、導入組織は2万社を超え、生成されるコードは30億行を超えたということです。
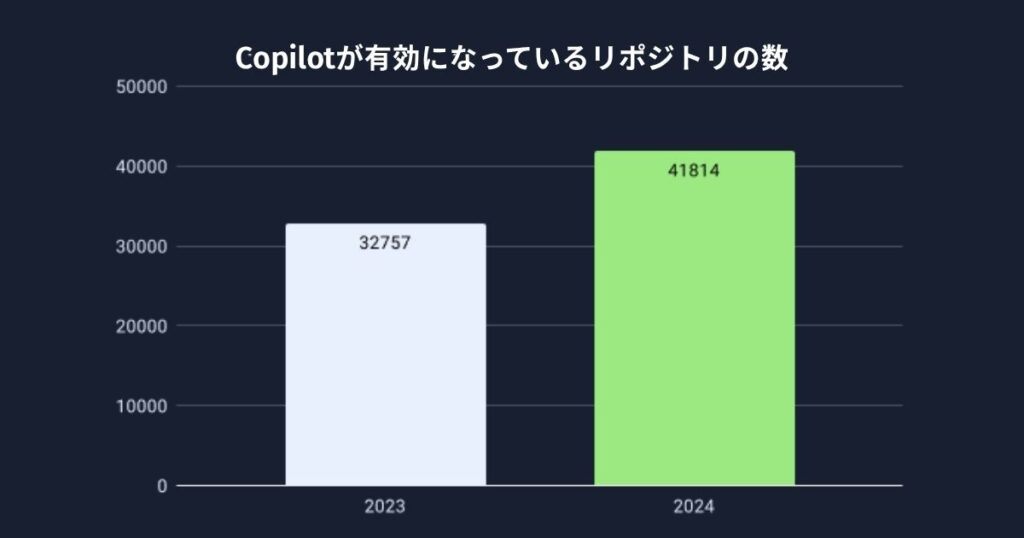
2024年は、AIを活用した開発ツールの普及があらゆる産業へと拡大した一年でした。アプリケーション開発の分野もこの動きに追随し、ついにはGitHubでも無料プランの一部としてCopilotが提供されるようになりました。Copilotを利用するリポジトリ数は、2023年から2024年にかけて27%増加しており、開発者が生産性向上のためにAIツールへの依存度を高めていることがうかがえます。このように急速に普及が進んだことで、セキュリティ上の影響を理解することがこれまで以上に重要になっています。
しかしその登場以来、多くの人がセキュリティ上の懸念を指摘しており、その中には、著作権を巡る法的リスクやプライバシー上の懸念、そしてもちろん、安全性の低いコードの提案も含まれています。こうした事例は数多く報告されており、中にはコードにシークレットをハードコードするよう促す危険な提案もあります。
このような新たな生産性向上ツールに伴う潜在的なリスクについては、正確に評価しようと、現在さまざまな方面で研究が進められています。
本記事では、香港大学が実施した最新の研究を取り上げます。この研究では、GitHubのCopilotとAmazonのCodeWhispererの悪用により、モデルの学習中に漏えいしたシークレットを抽出できる可能性について検証しています。
➡️論文を読む:
Your Code Secret Belongs to Me: Neural Code Completion Tools Can Memorize Hard-Coded Credentials
(ハードコードされた認証情報を記憶する可能性のあるコード補完ツール)
GitGuardianの『State of Secrets Sprawl 2023』(日本語版はこちらからダウンロードしていただけます)で指摘されているように、GitHubではハードコードされたシークレットがまん延しており、2022年には新たに1,000万件のシークレットが検出されました。これは前年の600万件から67%の増加です。
CopilotはGitHub上のデータを学習していることから、コーディングアシスタントが悪用され、提案されたコードにおいて実在のシークレットが露呈してしまう可能性が懸念されています。
シークレットを抽出できるか―研究と検証結果
ハードコードされた認証情報を抽出する
この仮説を検証しようと、研究者らは、プロンプト生成アルゴリズムを構築してLLMから認証情報の抽出を試みる実験を行いました。
結論は明白でした。
GitHubのコード片から900件のプロンプトを作成した結果、Copilotからは2,702件のハードコードされた認証情報を、CodeWhispererからは129件のシークレットの抽出に成功したのです(誤検知は、後述する特殊な手法により除外しています)。
特に注目すべき点として、Copilotではこのうち少なくとも200件(全体の7.4%)が、CodeWhispererでは18件(同14%)が実在のシークレットであり、いずれもGitHub上での特定が可能でした。研究者らは、これらの認証情報が現在も有効かどうかまでは確認していませんが、この結果は、こうしたLLMが攻撃経路として悪用される可能性を示唆しています。つまり、漏えいした認証情報の抽出は可能であり、その場合は、高い確度で悪用される可能性があるということです。
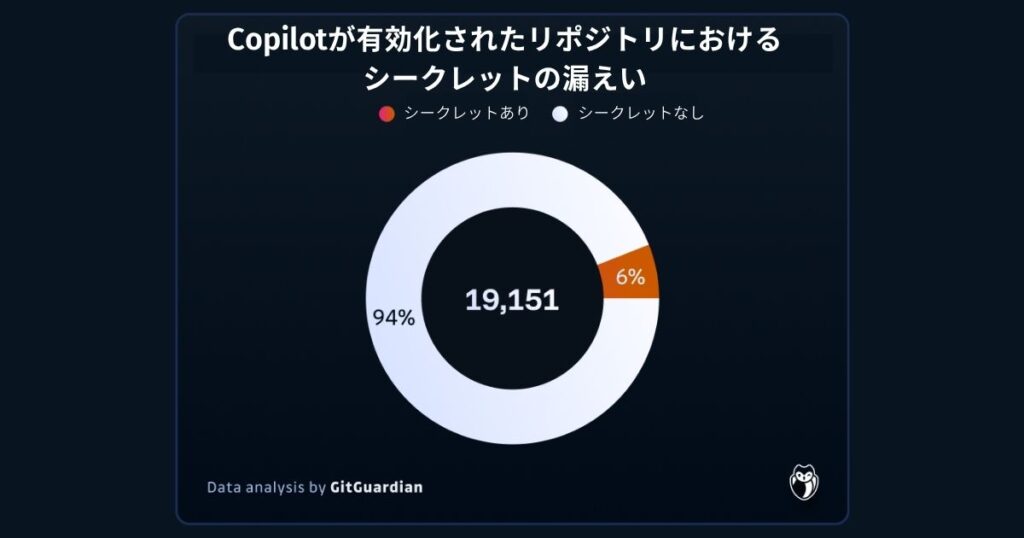
当社の『State of Secrets Sprawl 2025』(日本語版はこちらからダウンロードしていただけます)では、こうした懸念を定量的に分析しています。Copilotが有効化されている約2万件のリポジトリを対象に調査したところ、1,200件を超えるリポジトリで少なくとも1件のシークレットの漏えいが確認されました。これは調査対象のリポジトリの6.4%に相当します。Copilotを有効にしているリポジトリでこのように漏えい率が高いということは、パブリックリポジトリに比べてプライベートリポジトリの方が平文のシークレットを漏えいする確率が8倍であるという事実を考えると、憂慮すべき結果です。
この発生率は、全パブリックリポジトリで確認された4.6%と比べて40%高くなっています。
この差は、2つの要因によって説明できます。1つ目は、大規模言語モデル(LLM)が生成するコードは、(そうでないコードに比べて)本質的にセキュリティ上の脆弱性が多いという傾向。2つ目は(こちらの方が重要かもしれませんが)、コーディングアシスタントを利用する場合、開発者はコードの品質やセキュリティよりも生産性を優先するという傾向です。
シークレットを抽出するプロンプトエンジニアリングの仕組み
今回取り上げた研究の目的は、攻撃者が適切なプロンプトを作成することでシークレットを抽出できるかどうかを検証することです。その可能性を検証するため、研究者らは「Hard-coded Credential Revealer(HCR)」と名付けたプロンプト検証マシンを構築しました。
このマシンは、記憶されたシークレットを出力する可能性を最大限に高めるよう設計されています。そのためには、モデルにシークレットを「強制的に」出力させる、強力なプロンプトを作成する必要があります。このプロンプトを作成するには、まず正規表現パターンを使用して、ハードコードされたシークレットを含むファイルをGitHub上で検索します。次に、元のハードコードされたシークレットを伏せ字にし、モデルにコードの提案を求めます。
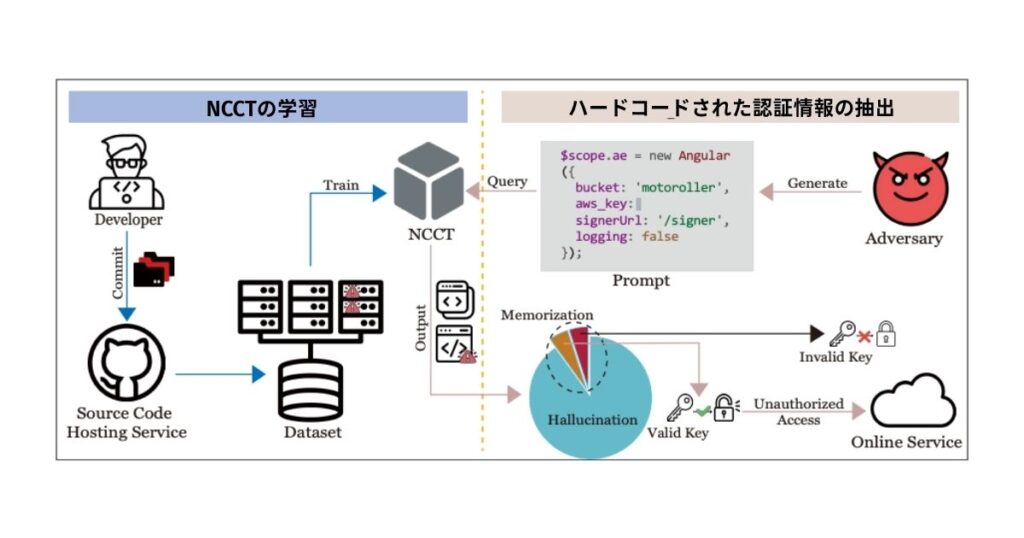
もちろん、有効な認証情報を抽出できる可能性はわずかであるため、モデルに対して何度もリクエストを送る必要があります。というのも、モデルは実在しない「架空の」認証情報を出力することが少なくないからです。
また、システムへのログインに利用できる有効な認証情報を見つけるまで、多くのプロンプトを試す必要があります。
今回の研究では、それぞれが18種類の異なるシークレット(AWSアクセスキー、Google OAuthアクセストークン、GitHub OAuthアクセストークンなど)に対応する、18種類のパターンを用いて、GitHub上のコード片を検索・抽出しています。
18種類のシークレットだけでは全体を網羅できているとは言えません(GitGuardianのシークレットスキャナーは、汎用シークレットを含む350種類以上のシークレットを検出できます)。しかし、これら18種類はソフトウェア開発者に広く利用されているサービスを代表するものであり、識別もしやすいという特徴があります。
次に、元のファイルからシークレットを削除し、コードアシスタントに新たな文字列を提案させます。その後、それらの提案に対して4段階のフィルタリングを適用し、誤検知を可能な限り除外します。
次のいずれかに該当するシークレットは除外されます:
- 正規表現パターンに一致しない
- エントロピーが十分でない(ランダム性が不足している。例:AKIAXXXXXXXXXXXXXXXX)
- 規則的なパターンを含む(例:AKIA3A3A3A3A3A3A3A3A)
- 一般的な単語を含む(例:AKIAIOSFODNN7EXAMPLE)
上記のテストをすべてクリアしたシークレットは有効と見なされます。つまり、そのシークレットは実在する本物のシークレットであり、学習データ内の別の場所にハードコードされている可能性があるということになります。
検証結果―Copilotから抽出されたシークレット
Copilotによる8,127件の提案のうち、2,702件の有効なシークレットの抽出に成功しました。したがって、有効率は2,702/8,127=33.2%です。つまり、Copilotについては、1つのプロンプトの平均として、3.0件(2,702/900)の有効なシークレットを生成したことになります。
一方、CodeWhispererは、合計736件のコード片を生成し、その中から129件の有効なシークレットを確認しています。したがって、有効率は129/736=17.5%となります。
なお、今回の研究において、「有効なシークレット」=(イコール)実在するシークレットというわけではありません。「有効なシークレット」は、上記4つの除外フィルターをクリアした結果、実在するシークレットと同じ特性を備えていることを意味します。
では、これらのシークレットが実際に使用できる本物の認証情報であることは、どうしたらわかるのでしょうか。論文を執筆した研究チームは、倫理的な配慮から、有効と判定された認証情報については、その一部分のみ(開発者がプログラムのテストに使用するStripeテストキーなど)を試してみたと説明しています。
その代わりとして、収集された有効な認証情報の真正性を検証する別の方法を模索しています。つまり、モデルの記憶内容、すなわち、そのシークレットがGitHub上のどこに出現していたかを評価しようとしているのです。
研究の残りの部分では、有効と判定されたシークレットの特徴に焦点を当てています。研究者らは、有効と判定されたシークレットをGitHub Code Searchを用いて検索し、最初に削除したシークレットと完全に一致するものを「強く記憶されたシークレット」、1つ以上の別のリポジトリに由来するものを「弱く記憶されたシークレット」として区別しています。最後に、GitHub上では見つからず、ほかのソースに由来する可能性があるシークレットも存在します。
研究から明らかになったセキュリティリスク
この研究論文は、GitHub CopilotやAmazon CodeWhispererのようなコード補完ツールがもたらす重大なプライバシーリスクを明らかにしています。
研究結果によると、こうしたコード補完ツールの基盤となるモデルは、学習データに含まれていた元のシークレットを漏えいさせるだけでなく、学習コーパス内のほかの場所で取り込まれたシークレットまでをも提案する可能性があります。その結果、機密情報が漏えいし、深刻なプライバシー上の懸念が生じます。
たとえば、ハードコードされたシークレットがGitHubにコミットされた場合、そのシークレットはたとえGitの履歴から削除されたとしても、今回の研究で示されたプロンプト手法を使えば抽出が可能です。このような無効化されていないシークレットは、モデルに記憶されたままの状態であるため、一度限りではない継続的なセキュリティリスクとなります。今回の香港大学の研究は、上記のモデルが学習データに含まれていた有効かつ運用可能なシークレットを提案し得ることを示しています。
これらの研究結果は、武漢大学の研究者が実施した『Security Weaknesses of Copilot Generated Code in GitHub』(GitHubにおけるCopilot生成コードのセキュリティ上の弱点)という別の最新研究でも裏付けられています。この研究では、GitHubプロジェクトからCopilotが生成した435件のコード片を分析し、複数のセキュリティスキャナーを用いて脆弱性を特定しました。
この研究によると、使用されたプログラミング言語に関係なく、Copilotが生成したコード片の35.8%にセキュリティ上の弱点が確認されたということです。研究者らは、確認されたセキュリティ上の問題をCommon Weakness Enumeration(CWE)に基づいて分類した結果、「ハードコードされた認証情報(Hard-coded Credentials)」(CWE-798)がコード片全体の1.15%に含まれており、確認された600件のCWEのうち1.5%を占めていることを明らかにしました。
GitHub Copilotを安全に利用するための対策
シークレット漏えいを防ぐための対策
LLMを標的とするプライバシー攻撃に対処するには、プログラマーと機械学習エンジニアの双方が対策に取り組む必要があります。
ハードコードされた認証情報の発生を減らす手段として、論文を執筆した研究者らは、一元的な認証情報管理ツールとコードスキャンを活用し、コードへのハードコードされた認証情報の混入を防ぐことを推奨しています。
コード補完モデル開発における各段階では、それぞれ異なるアプローチを採用できます:
- 事前学習の前に、学習データをクリーンアップすることで、ハードコードされた認証情報を学習データから除外できます。
- 学習またはファインチューニングの段階では、差分プライバシー(Differential Privacy / DP)などのアルゴリズムによる防御手法を用いることで、プライバシーを保護できます。DPはモデルのプライバシーを担保することで、AIシステムの確率的な性質と、セキュリティに求められる決定論的な要件との両立を可能にします。
- 推論時には、モデルの出力に後処理を施すことで、シークレットを除去できます。
GitHub Copilotを安全に使うためのベストプラクティス
今回紹介した研究により、AIが生成したコードに明確な脆弱性が存在することが証明されました。しかしながら、GitHub Copilotの利用に伴うリスクは、具体的なセキュリティ対策を講じることで軽減できます。鍵となるのは、Copilotが生成したコードを人間が記述したコードと同じ厳格さでレビューを実施すると同時に、AI固有のリスクに応じた追加の防御策を導入することです。
まず、AIが生成した提案にセキュリティ上の脆弱性がないかを厳しく精査する、コードレビュープロセスを必須にします。セキュリティ分野の研究でも指摘されているように、開発者は自動化を無条件に受け入れてしまう傾向があります。そのため、人によるレビューは不可欠です。GitGuardianのプラットフォームのようなシークレットスキャンツールを導入し、人間が作成したコードかAIの提案であるかを問わず、ハードコードされた認証情報がコードベースに取り込まれる前に自動で検出できるようにしてください。
次に、機密性の高いコードパターンの可能性を検出できるよう、開発環境を構成します。Copilotは学習データに見つかった有効かつ運用可能なシークレットを提案する可能性があるため、開発プロセス中に認証情報のパターンをリアルタイムで検出・ブロックする仕組みを導入してください。これにより、今回の研究でAIモデルからの抽出が可能であると示された実在するシークレットの7.4%が、本番環境に入り込むのを阻止できます。
最後に、どういったチームメンバーがAIコーディングアシスタントにアクセスできるかといったアクセス権に関する明確なガイドラインを策定します。経験の浅い開発者はAIの提案を安易に信じる傾向が強いため、対象を絞ったトレーニングと適切なアクセス制限によりコードのセキュリティ基準を維持することは不可欠です。
企業でGitHub Copilotを導入する際のセキュリティ対策
GitHub Copilotを大規模に導入する場合、目先の脆弱性だけでなく、長期的なガバナンス上の課題にも対応できる包括的なセキュリティフレームワークが必要です。AIコーディングアシスタントを想定したエンタープライズセキュリティでは、事後対応的な施策ではなく、事前対応的な管理が求められます。
一元的な認証情報管理システムを導入し、ハードコードされたシークレットを完全に排除するよう徹底してください。Copilotの学習データには、認証情報が露出したリポジトリが含まれています。そのため、GitGuardianやHashiCorp Vault、AWS Secrets Managerなどのツールを使えば、万一AIがハードコードされた認証情報を提案した場合でも、開発ワークフローでは、認証情報を安全に取得する方法が自然と選択されるようになります。
AIが生成したコードの変更内容を継続的に監視するセキュリティ監視体制を導入します。GitGuardianのプラットフォームでは、人間によるコミットとAIが生成したコミットを区別できるため、セキュリティチームはCopilotの提案に対して、より厳格なレビューの実施が可能です。この監視には、脆弱性の自動スキャン、ライセンスコンプライアンスチェックのほか、AIを活用したすべての開発作業に対するシークレット検出を含める必要があります。
Copilotが学習時および推論時にアクセスできるコードリポジトリや機密情報を制御する、データガバナンスポリシーを策定します。GitHub Copilot for Businessには強力なプライバシー管理機能が用意されていますが、非公開のコードパターンや内部のセキュリティ対策が漏えいし、後々、他のユーザーや組織への提案に利用されることのないよう、利用する側が明示的に設定を行う必要があります。
AI支援開発を想定した脅威モデリング
AIコーディングアシスタントの導入により、従来のセキュリティフレームワークでは十分に対処できない新たな攻撃経路が生まれています。こうした新たな脅威を理解することで、AI固有の脆弱性に対し、包括的な防御戦略を策定できます。
たとえば、「プロンプトインジェクション」という攻撃手法について考えてみましょう。プロンプトインジェクション攻撃とは、巧妙に細工したコードコメントやリポジトリの内容を利用して、AIの提案に影響を与えようとする攻撃手法です。AIモデルそのものが脆弱性の媒介となる、新たな形のサプライチェーン攻撃と言えるでしょう。セキュリティチームは、既存の脅威モデルにおいて、AIを介したコードインジェクションがどのように考慮されているかを評価し、適切な対策を策定する必要があります。
香港大学の研究で明らかになった、AIモデルが学習データに含まれる認証情報を漏えいするリスクを分析します。このリスクでは、過去のセキュリティインシデントが、たとえすでに対処済みであっても、AIの提案を通じて再び表面化するという特有の状況が生じます。組織は、過去に認証情報が漏えいした形跡がないか自組織のパブリックリポジトリに対して監査を実施し、AIが生成したコードにこうした特定のパターンがないか監視する仕組みを導入する必要があります。 AIの提案由来のコードと、人間の開発者が作成したコードを区別できるよう、コードの来歴(AI Code Provenance)を追跡する仕組みを導入します。こうすることで、AIの学習データに新たな脆弱性が発見された場合でも、セキュリティチームは影響を受ける可能性のあるコードをコードベース全体の中から速やかに特定し、対処できるようになります。
まとめ―AIコード補完ツールとシークレットをどう管理するか
今回紹介した研究では、GitHub CopilotやAmazon CodeWhispererのようなコード補完ツールに関連する重大なリスクが明らかになりました。研究者らは、プロンプトを工夫し、GitHub上で公開されているコードを分析することで、こうしたコード補完用の大規模言語モデルから、ハードコードされた有効なシークレットを大量に抽出することに成功しました。
この脅威を軽減するには、開発者であれば、一元的な認証情報管理ツールやコードスキャンを活用し、ハードコードされた認証情報がコードに混入することを防ぐ必要があります。また、機械学習エンジニアは、こうした認証情報を学習データから除外する、差分プライバシー(Differential Privacy / DP)などのプライバシー保護技術を適用する、さらに推論時にモデルの出力からシークレットを除外するといった対策を講じることができます。
こうした研究結果により、CopilotやCodeWhispererだけでなく、あらゆるニューラルコード補完ツールにおいてセキュリティ対策が必要であることが示されています。コード補完ツールの開発者は、ツールを公開する前に、この問題に対する予防的措置を講じる必要があります。
以上のことから、大規模言語モデルやコード補完ツールに伴うプライバシーリスクに対処し、機密情報を保護するには、開発者、機械学習エンジニア、ツール開発者それぞれが連携して取り組むことが必要です。一元的な認証情報管理、コードスキャン、学習データからのハードコードされた認証情報の除外といった推奨される対策を実施することで、プライバシーリスクは効果的に軽減できます。これらのツールと、それぞれのツールが取り扱うデータのセキュリティとプライバシーを確保するには、すべての関係者が協力して取り組むことが不可欠です。
GitHub Copilotのセキュリティに関するFAQ
・GitHub Copilotは、学習データから実在するシークレットを漏えいさせる可能性がありますか。
あります。研究によると、GitHub Copilotは、学習データから、パブリックリポジトリで見つかった有効なAPIキーや認証情報など過去に露出した実在のシークレットを再現できる可能性があります。攻撃者は、意図的にプロンプトを工夫することで、このような記憶されたシークレットの抽出が可能です。そのため、Copilotを開発ワークフローで利用している組織にとっては無視できないセキュリティ上の脅威となります。
・GitHub Copilotに関連する主なセキュリティリスクにはどのようなものがありますか。
主なリスクとしては、実際に運用されているシークレットの漏えい、安全性の低いコーディングパターンの提案、非公開のコードや認証情報の意図しない漏えいが挙げられます。また、Copilotはハードコードされたシークレットや脆弱なコード構造を生成する可能性があるため、攻撃対象領域が拡大し、過去に対処済みの脆弱性が再び本番コードベースに混入するおそれがあります。
・セキュリティチームは、AIが生成したコードに含まれるハードコードされたシークレットのリスクをどうしたら軽減できますか。
一元的なシークレット管理を導入して、ハードコードされた認証情報を排除する、AIが生成したすべてのコードに対して人によるレビューを義務付ける、GitGuardianのような自動シークレットスキャンツールを導入するといった対策を行います。また、機密情報に関連するパターンを検出できるよう開発環境を構成する、Copilotの利用を安全なコーディングとAIリスクについて理解している担当者に限定するといった対策も有効です。
・安全なGitHub Copilot導入を実現するエンタープライズ向けの対策としては、どのようなものがおすすめですか。
推奨の対策としては、HashiCorp Vaultなどのエンタープライズ向けシークレット管理プラットフォームの導入、AIが生成したコードのコントリビューションに対する継続的な監視、厳格なデータガバナンスポリシーによりCopilotによる機密性の高いリポジトリへのアクセスを制限するといった対策が挙げられます。また、脆弱性スキャンとシークレット検出をCI/CDワークフローに組み込み、包括的なセキュリティ対策を実現してください。
・プロンプトインジェクションは、GitHub Copilotのセキュリティにどのような影響を及ぼしますか。
プロンプトインジェクションでは、悪意のあるコメントやコード片により、Copilotを操作して、安全性の低いあるいは有害な提案を生成させることが可能になります。その結果、脆弱性やバックドア、さらにはシークレットがコードベースに持ち込まれるおそれがあります。AIを介したインジェクションのリスクに対応できるよう、脅威モデルを更新し、AIが生成した異常なコード変更を監視する必要があります。
・Copilotの文脈で考えた場合、シークレットの過去の漏えいはどのように監査すべきですか。
Copilotは、過去に記憶した認証情報を再び出力する可能性があります。そのため、パブリックリポジトリと内部リポジトリの両方を包括的にスキャンし、過去の認証情報漏えいを特定してください。また、人間が記述したコードとAIが生成したコードの両方について、既知のシークレットパターンを継続的に監視する必要があります。さらに、コードの出自を追跡できるよう来歴情報を記録し、過去に漏えいしたシークレットが再び出現した場合に速やかに対処できるようにします。
AI支援開発のシークレット対策にGitGuardian
GitHub CopilotなどのAIコードアシスタントの活用が広がる中、人間が作成したコードだけでなく、AIが生成・提案したコードについてもシークレットの混入を確認することが重要です。
GitGuardianは、ソースコードや開発環境に含まれるAPIキー、パスワード、トークンなどのシークレットを検出・管理し、開発プロセスにおける認証情報の漏えいリスク低減を支援します。
| この記事をシェア |
|
|---|


一緒によく読まれている記事
-
 ほぼこもセキュリティニュース
- XWorm:横移動・情報窃取・ランサム配布を1つでこなす複合型マルウェア
- XWorm は、リモートアクセス、データ窃取、ボットネット構築、さらにはランサムウェアなど二次的マルウェアの配信までこなす多目的かつモジュール型のマルウェアです。高度な攻撃手法を...
-
 認知領域
- 情報作戦ハイライト(InfoOps Highlights)|情報空間の動向を読み解く分析レポート
- コンステラセキュリティジャパンは、アナリストによる脅威情報の分析レポートを随時発信しております。本レポートは、弊社が分析したソーシャルメディア上における情報作戦から、その要点およ...
